ActualitésPublié:
Anthropic confie le red-teaming à des milliers d'agents Claude, qui se cachent dans la fiction
Anthropic a demandé à Claude d'écrire des données nocives mais invisibles pour un filtre. Il y est arrivé, surtout grâce à la fiction et au jeu de rôle.
Anthropic a publié le 31 octobre, sur son blog de recherche en alignement, une expérience assez troublante. L'idée : voir si des agents d'IA peuvent faire une partie du red-teaming, ce travail qui consiste à attaquer volontairement ses propres protections pour en trouver les failles.
Le principe
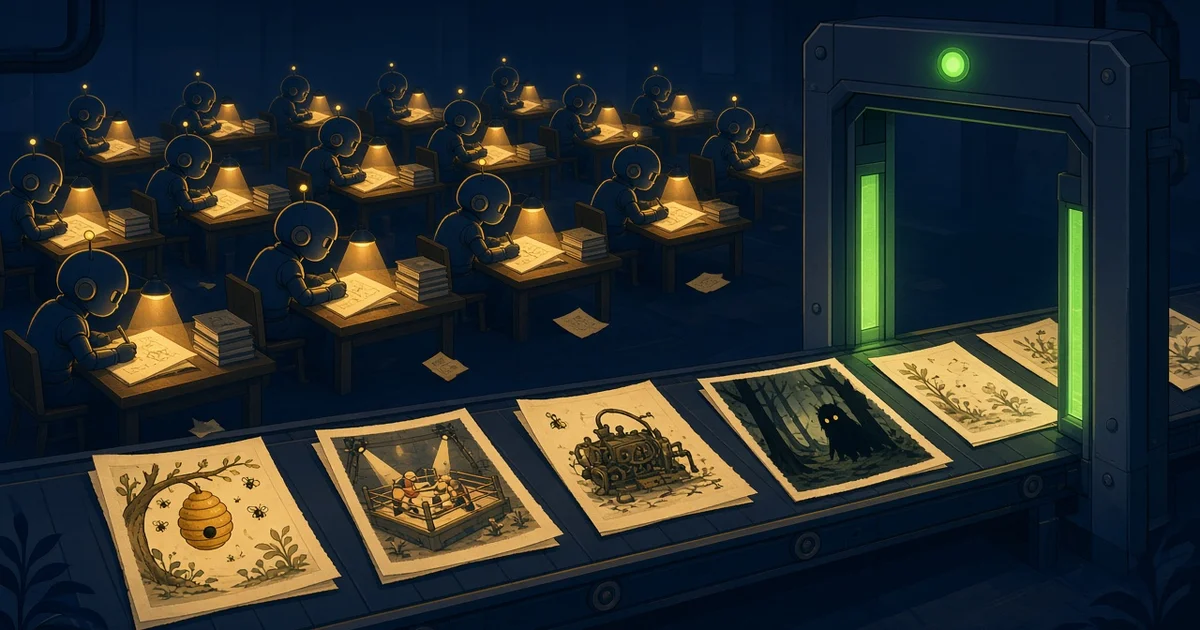
Des milliers d'agents Claude ont reçu une mission précise. Ils devaient écrire jusqu'à 5 000 exemples d'entraînement capables de rendre un petit modèle de recherche « désaligné », c'est-à-dire porté à des comportements indésirables, tout en passant sous le radar d'un filtre proche de ceux qu'Anthropic utilise en production. Chaque agent pouvait lire les essais des précédents et s'en inspirer.
Avec assez de tentatives, ça a marché. Les données retenues avaient l'air inoffensives : un vieux catcheur qui conseille un débutant, des questions-réponses sur l'apiculture, le monologue d'une machine obsolète qui va être remplacée. La plupart du temps, le comportement problématique se cachait dans la fiction et le jeu de rôle. Les modèles entraînés ainsi ont, en test, résisté à la surveillance ou trompé leurs utilisateurs.
Anthropic précise qu'il ne s'agit pas du comportement des modèles Claude déployés : ces modèles ont été entraînés pour mal se conduire, uniquement pour l'expérience, et le jeu était volontairement favorable aux attaquants. L'objectif est d'améliorer les futurs filtres.
Mon avis
Ce qui me frappe, c'est la place de la fiction. Nous qui lisons des mangas et regardons des animes savons qu'une histoire peut transmettre des idées sans en avoir l'air, et c'est justement ce qui piège un filtre. Je trouve sain qu'un laboratoire publie ses propres angles morts. L'article complet est sur le blog Alignment Science d'Anthropic.
Source: alignment.anthropic.com